
Cortex One — IA d'entreprise auto-hébergée | Apeiron
Recherche agentique, agents sur mesure et 50+ connecteurs : votre IA d'entreprise déployée par Apeiron en Tunisie et en France, dans votre infrastructure.
Parlons-en
Cortex One — La plateforme d'IA d'entreprise auto-hébergée d'Apeiron
« Les LLM savent tout ce qui est public, mais s'ils pouvaient aussi savoir ce qui se passe dans notre équipe ? Je veux un collègue IA, pas un nouvel employé IA. »
En bref
- Catégorie : IA d'entreprise, recherche agentique et agents sur mesure
- Déploiement : auto-hébergé (Docker, Kubernetes, AWS ECS), cloud privé ou environnement isolé (air-gapped)
- Sources : 50+ applications connectées, avec leurs permissions
- Modèles : tous les grands fournisseurs, ou modèles auto-hébergés (Ollama, vLLM, LiteLLM)
- Base : projet open source Onyx (licence MIT), personnalisé et déployé par Apeiron
Pourquoi Cortex One
Dans une entreprise, la connaissance utile est dispersée : tickets Jira, pages Confluence, conversations Slack, documents Google Drive, code GitHub, CRM, support client. Un assistant IA généraliste ne voit rien de tout cela. Et brancher un LLM public sur ces outils pose immédiatement deux questions : où vont les données, et qui a le droit de voir quoi.
Cortex One répond aux deux. C'est la couche de connaissance et de contexte de votre équipe et de vos agents IA : elle se connecte à vos applications, indexe leur contenu avec leurs métadonnées et leurs droits d'accès, puis le rend disponible à une interface de chat, à des agents spécialisés et à tout client compatible MCP — le tout dans votre propre infrastructure.
Concrètement, vos collaborateurs posent une question en langage naturel — « Où en est le contrat de ce client ? », « Quelle est notre procédure de mise en production ? », « Qu'avons-nous décidé sur ce sujet le mois dernier ? » — et obtiennent une réponse sourcée, construite uniquement à partir des documents auxquels ils ont accès.
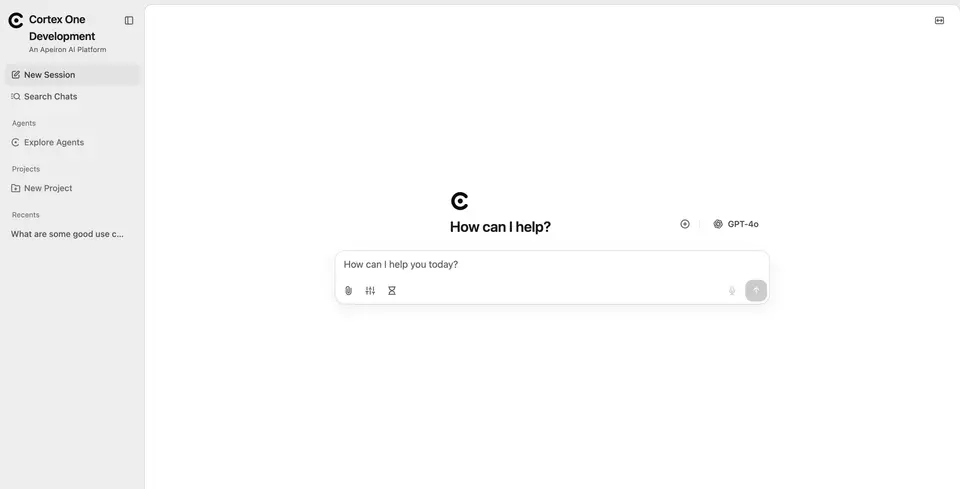 L'application web : sessions de chat, recherche dans l'historique, agents, projets, saisie vocale et choix du modèle.
Comment ça marche
Cortex One construit une représentation unifiée de la connaissance de l'entreprise. Le fonctionnement se découpe en deux temps.
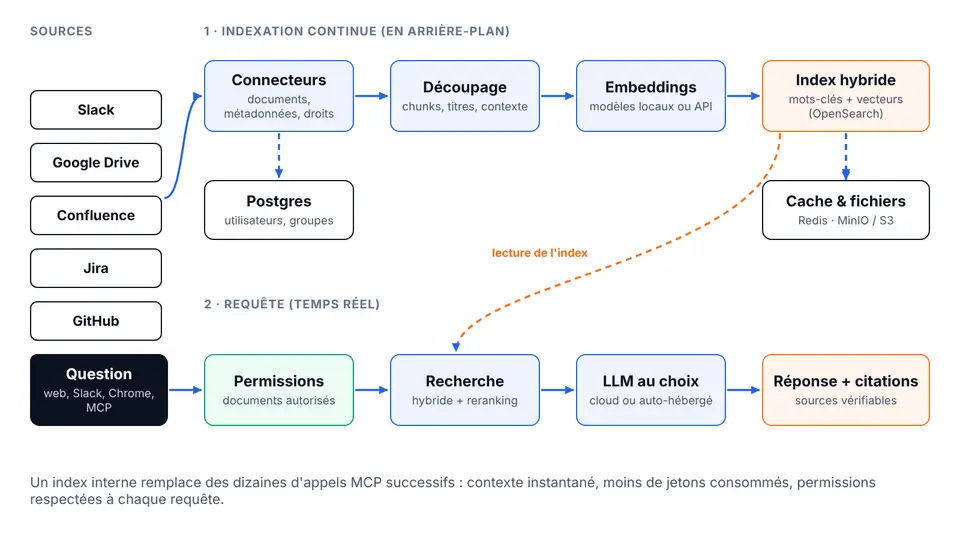 Deux chaînes distinctes : une indexation continue en arrière-plan, et une requête en temps réel filtrée par les permissions.
1. Indexation continue
- Des connecteurs récupèrent les documents avec leurs métadonnées (auteur, dates, source) et leurs permissions.
- Les contenus sont découpés, transformés en embeddings par un modèle de votre choix, puis stockés dans un index hybride qui combine recherche par mots-clés et recherche vectorielle.
- Les utilisateurs, groupes et droits sont conservés en base relationnelle, pour que chaque requête puisse être filtrée.
- Des workers en arrière-plan resynchronisent régulièrement les sources : l'index reste à jour sans intervention.
2. Requête en temps réel
- La question de l'utilisateur est d'abord filtrée par ses permissions : seuls les documents qu'il peut ouvrir dans l'outil d'origine sont éligibles.
- Une recherche hybride suivie d'un reranking sélectionne les passages les plus pertinents.
- Le LLM rédige la réponse à partir de ces passages et cite ses sources.
Pourquoi un index plutôt que des appels MCP en cascade
Les approches « sans index » demandent à un agent d'interroger successivement des dizaines d'outils via MCP, en consommant beaucoup de jetons, avec une latence élevée et des résultats variables. Cortex One interroge sa représentation interne instantanément et ne renvoie au modèle que les documents les plus pertinents : contexte plus fiable, plus rapide, moins coûteux.
Les fonctionnalités clés
- RAG agentique — une recherche de haute qualité fondée sur un index hybride et un agent réglé pour la récupération d'information.
- Deep Research — des rapports approfondis produits par un flux de recherche en plusieurs étapes.
- Agents sur mesure — des agents IA avec leur propre sous-ensemble de connaissances, leurs instructions et leurs actions.
- Recherche web — pour compléter la connaissance interne : Serper, Google PSE, Brave, SearXNG, un crawler maison, et la prise en charge de Firecrawl et Exa.
- Actions externes et MCP — les agents agissent dans vos applications pour mener une tâche de bout en bout.
- Bac à sable sécurisé — exécution de code et manipulation d'artefacts intermédiaires pour les workflows complexes.
- Artefacts — génération de documents, graphiques et autres fichiers téléchargeables.
- Mode vocal — dialogue en synthèse et reconnaissance vocales.
Une connaissance reliée à toutes vos applications
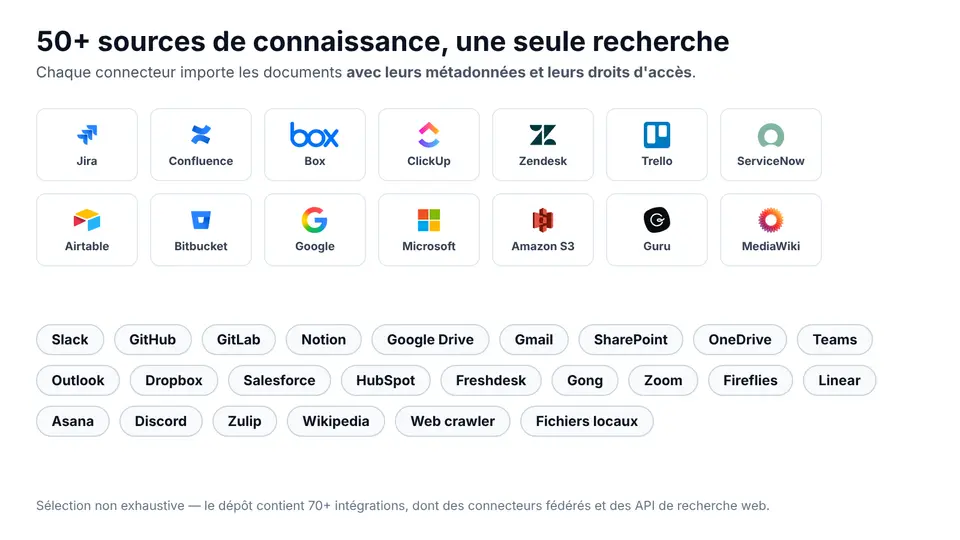 Jira, Confluence, Google Drive, SharePoint, Slack, GitHub, Notion, Salesforce, Zendesk… et le crawler web pour les sites publics.
Cortex One embarque des connecteurs pour les outils où vit réellement le travail : messagerie et collaboration (Slack, Teams, Discord, Gmail, Outlook), documentation (Confluence, Notion, SharePoint, Google Drive, Dropbox, Box), tickets et gestion de projet (Jira, Linear, Asana, ClickUp, Trello), code (GitHub, GitLab, Bitbucket), CRM et support (Salesforce, HubSpot, Zendesk, Freshdesk), réunions (Zoom, Gong, Fireflies), sans oublier les fichiers locaux et le crawl de sites web.
Chaque connecteur importe le contenu avec ses droits d'accès : un collaborateur qui n'a pas accès à une page Confluence ne la verra jamais apparaître dans une réponse, quelle que soit la façon dont il pose sa question.
Souveraineté des données et sécurité
Quand on connecte la connaissance d'une organisation, la propriété intellectuelle doit rester protégée, vis-à-vis de l'extérieur comme de l'intérieur.
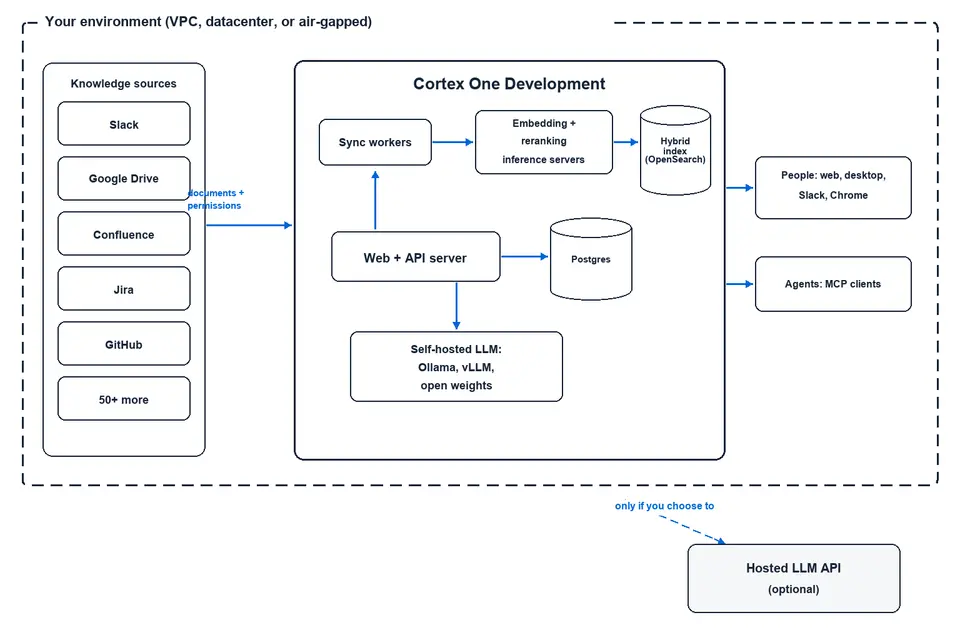 Tout s'exécute dans votre environnement (VPC, datacenter ou air-gapped). Seul l'appel à une API de LLM hébergée sort du périmètre — et uniquement si vous le choisissez.
- Déploiement isolable : l'index documentaire, la base de données et le traitement tournent dans un ensemble de services autonomes que vous contrôlez, y compris sans accès à Internet.
- Modèles maîtrisés : vous choisissez le modèle d'embedding et le LLM, qui peuvent aussi tourner en local.
- Permissions respectées partout : les mêmes règles s'appliquent, que la question vienne du web, de Slack, de Chrome ou d'un agent MCP.
- Traçabilité : historique des requêtes et journal d'audit pour encadrer l'adoption de l'IA (fonctions entreprise).
Un accès depuis partout
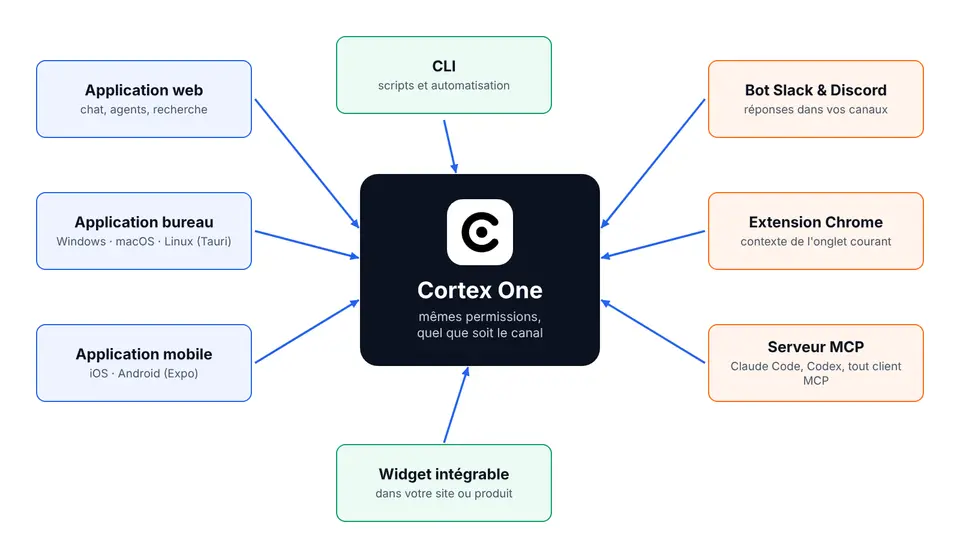 Un seul moteur de connaissance, huit façons de l'utiliser, avec les mêmes permissions.
- Application web et application bureau (Windows, macOS, Linux) — poser des questions et piloter ses agents.
- Application mobile (iOS et Android) — la connaissance de l'équipe en mobilité.
- Bot Slack et Discord — des réponses directement dans vos canaux, fondées sur la connaissance de l'organisation.
- Extension Chrome — interroger Cortex One depuis n'importe quel onglet, avec le contexte de la page.
- Serveur MCP — brancher Claude Code, Open Code, Codex ou tout client MCP : vos agents de développement accèdent au contexte de l'entreprise avec les droits de la personne qui les lance.
- Widget intégrable — ajouter les fonctions de Cortex One à votre site ou à votre produit.
- CLI — scripts et automatisations.
Vous choisissez le modèle
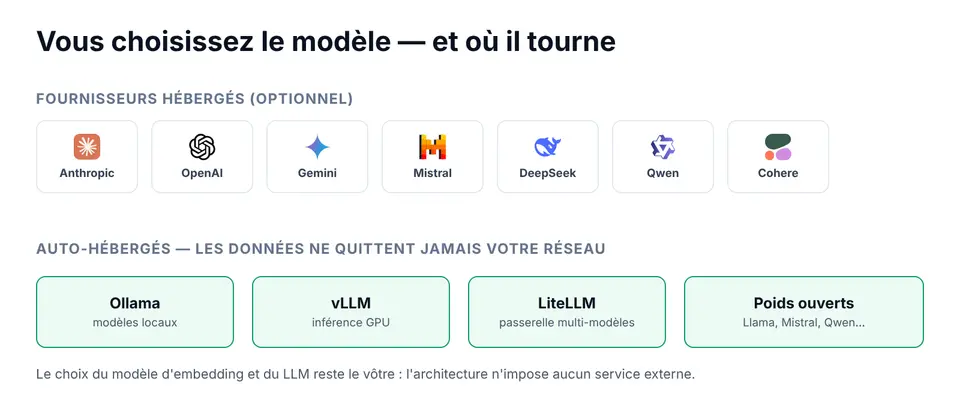 Fournisseurs hébergés en option, ou modèles totalement auto-hébergés.
Cortex One prend en charge les grands fournisseurs propriétaires (Anthropic, OpenAI, Gemini, Mistral, Cohere, DeepSeek, Qwen…) comme les modèles auto-hébergés via Ollama, vLLM ou LiteLLM. Vous pouvez changer de modèle sans changer d'outil, comparer les coûts, ou imposer un modèle local pour les contenus sensibles.
Deux modes de déploiement
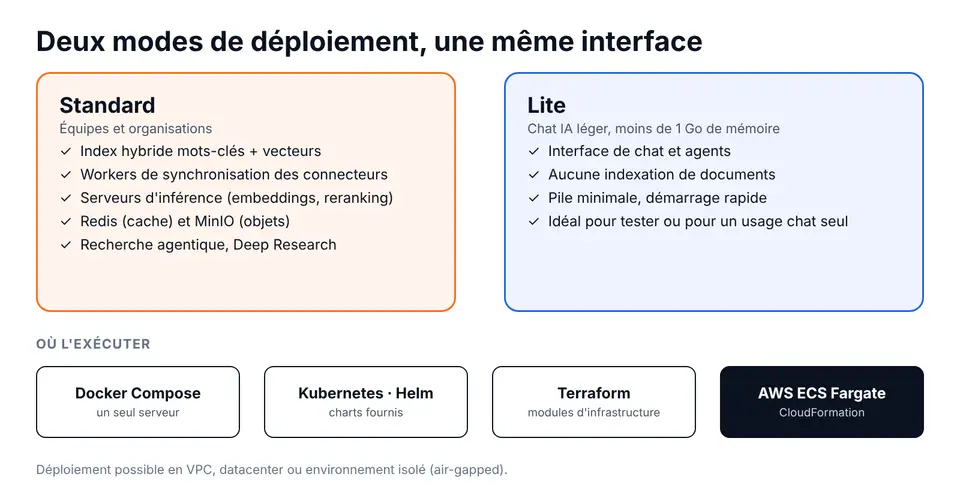 Standard pour les équipes et organisations, Lite pour un chat IA léger.
| Standard | Lite | |
|---|---|---|
| Usage | Équipes et organisations | Test rapide, chat et agents seuls |
| Index documentaire | Oui (mots-clés + vecteurs) | Non |
| Synchronisation des connecteurs | Oui, via des workers | Non |
| Serveurs d'inférence (embeddings, reranking) | Oui | Non |
| Cache et stockage objet | Redis, MinIO | Non |
| Empreinte | Pile complète | Moins de 1 Go de mémoire |
Pour un premier essai, la pile complète se lance en local avec Docker Compose. En production, Cortex One se déploie sur Docker, Kubernetes (charts Helm), Terraform ou AWS ECS Fargate (CloudFormation), avec des guides pour les grands fournisseurs cloud.
Fonctions pour les organisations
Au-delà du noyau open source, la plateforme intègre des fonctions pensées pour les équipes de toute taille :
- Collaboration : partage de conversations et d'agents entre membres de l'organisation.
- Authentification unique : SSO via Google OAuth, OIDC ou SAML, synchronisation des groupes et provisioning SCIM.
- Contrôle d'accès par rôle (RBAC) : accès aux agents, aux actions et aux ressources sensibles.
- Analytique : graphiques d'usage par équipe, par modèle ou par agent.
- Historique des requêtes : audit de l'usage pour une adoption maîtrisée.
- Code personnalisé : suppression de données personnelles, rejet de requêtes sensibles, analyses sur mesure.
- Marque blanche : nom, icônes, bannières et identité visuelle à vos couleurs.
Sous le capot
| Couche | Technologies |
|---|---|
| Backend et API | Python, FastAPI, Celery (tâches de fond), SQLAlchemy et Alembic |
| Stockage | PostgreSQL, index hybride OpenSearch, Redis (cache), MinIO / S3 (fichiers) |
| Modèles | Serveurs d'inférence dédiés (embeddings, reranking), LiteLLM, serveur MCP |
| Interface web | Next.js, React, Tailwind CSS |
| Clients | Application bureau (Tauri), application mobile (Expo), extension Chrome, CLI en Go |
| Déploiement | Docker Compose, Helm, Terraform, AWS ECS Fargate |
Cas d'usage
- Support client : retrouver en quelques secondes la bonne procédure, le bon ticket et la bonne réponse type.
- Intégration des nouveaux arrivants : un assistant qui connaît la documentation, les décisions passées et les outils de l'équipe.
- Ingénierie : questions sur le code, les tickets et les runbooks, y compris depuis un agent de développement via MCP.
- Ventes et avant-vente : réponses à un appel d'offres à partir des propositions et références existantes.
- Direction et conformité : synthèses et rapports de recherche approfondie, avec sources citées et traçabilité des usages.
- Équipes sous contrainte de souveraineté : banque, assurance, santé, secteur public, industrie — là où les données ne doivent pas quitter le périmètre.
Comment Apeiron le livre
- Cadrage. Nous identifions les sources de connaissance prioritaires, les cas d'usage, les contraintes de sécurité et le niveau de souveraineté requis.
- Architecture et déploiement. Mise en place sur votre infrastructure ou votre cloud privé (Docker, Kubernetes, AWS), avec réseau, sauvegardes, observabilité et, si besoin, mode isolé.
- Connexion des sources. Configuration des connecteurs, des identifiants et de la synchronisation, avec contrôle des permissions de bout en bout.
- Choix des modèles. Sélection du LLM et du modèle d'embedding selon qualité, coût, langue (français, arabe, anglais) et sensibilité des données.
- Agents sur mesure. Création d'agents métier — support, ventes, RH, ingénierie — avec leurs connaissances, leurs instructions et leurs actions.
- Authentification et gouvernance. SSO, rôles, groupes, journalisation et règles de protection des données.
- Marque et accès. Personnalisation à votre image, déploiement du bot Slack, de l'extension Chrome, du widget ou du serveur MCP.
- Formation et évolution. Prise en main des équipes, mises à jour, nouveaux connecteurs et amélioration continue de la qualité des réponses.
Pour qui
- PME et ETI qui veulent un assistant interne sur leurs outils sans envoyer leurs données chez un tiers.
- Directions informatiques qui doivent encadrer l'usage de l'IA avec des rôles, un audit et des permissions.
- Équipes produit et ingénierie qui souhaitent donner du contexte d'entreprise à leurs agents de code via MCP.
- Organisations régulées qui exigent un déploiement maîtrisé, jusqu'à l'environnement isolé.
Licence et attribution
Cortex One est construit sur le projet open source Onyx, publié sous licence MIT (Copyright © 2023-présent DanswerAI, Inc.). Les mentions de copyright et de licence d'origine sont conservées. Le noyau — RAG, chat IA, agents et actions — est disponible sous licence MIT ; les fonctions réservées aux grandes organisations, situées dans les répertoires ee/, relèvent de l'Onyx Enterprise License et nécessitent une licence valide. Apeiron apporte l'intégration, la personnalisation, le déploiement et l'accompagnement.
Pourquoi choisir Cortex One avec Apeiron
- Vos données restent chez vous : déploiement dans votre périmètre, modèles de votre choix.
- Pas de vendor lock-in : base open source, standards ouverts (MCP), infrastructure standard.
- Une équipe qui livre : Apeiron conçoit et exploite des solutions d'IA agentique, d'ERP et de logiciels sur mesure pour des clients en France et en Tunisie.
- Un seul interlocuteur : du cadrage à l'exploitation, avec un accompagnement en français, en arabe et en anglais.
Questions fréquentes
Cortex One est-il vraiment auto-hébergeable, sans envoyer de données à un tiers ?
Oui. L'index documentaire, la base de données et le traitement tournent dans votre environnement (VPC, datacenter ou environnement isolé). Seul l'appel à une API de LLM hébergée sort du périmètre, et uniquement si vous choisissez ce mode : vous pouvez aussi utiliser un modèle auto-hébergé avec Ollama, vLLM ou LiteLLM.
Quelle différence entre Cortex One et un chatbot IA généraliste ?
Un chatbot généraliste ne connaît ni vos documents ni vos droits d'accès. Cortex One indexe vos applications (Slack, Confluence, Jira, Google Drive, GitHub…) avec leurs permissions et répond avec des sources, uniquement à partir de ce que chaque personne a le droit de voir.
Quelles applications peut-on connecter à Cortex One ?
Plus de 50 sources : messagerie et collaboration, documentation, tickets et gestion de projet, code, CRM et support, réunions, fichiers locaux et crawl de sites web. Nous configurons les connecteurs prioritaires pendant le déploiement.
Cortex One fonctionne-t-il avec Claude, GPT ou des modèles open source ?
Oui. La plateforme prend en charge les grands fournisseurs (Anthropic, OpenAI, Gemini, Mistral, Cohere, DeepSeek, Qwen…) et les modèles auto-hébergés. Vous pouvez changer de modèle sans changer d'outil.
Peut-on utiliser Cortex One avec Claude Code ou d'autres agents via MCP ?
Oui. Cortex One expose un serveur MCP : Claude Code, Open Code, Codex ou tout client MCP accède au contexte de l'entreprise avec les droits de la personne qui lance l'agent.
Quelle est la différence entre le mode Standard et le mode Lite ?
Le mode Standard inclut l'index hybride, les workers de synchronisation et les serveurs d'inférence pour indexer vos documents. Le mode Lite est une interface de chat et d'agents légère, sans indexation, qui tient en moins de 1 Go de mémoire.
Combien coûte un déploiement de Cortex One ?
Le noyau open source est sous licence MIT, sans coût de licence par utilisateur. Le budget dépend de l'infrastructure, du nombre de sources, des modèles choisis et des fonctions entreprise souhaitées. Nous chiffrons après un atelier de cadrage.
Apeiron peut-il réaliser un POC de Cortex One avant un déploiement complet ?
Oui. Nous proposons un POC sur un périmètre réduit (quelques sources et un cas d'usage) pour mesurer la qualité des réponses avant de généraliser. Voir aussi notre développement de MVP et POC.
Voir aussi
- Agence IA en Tunisie : agents, RAG et automatisation
- Développement MVP et POC
- Orchestration d'agents IA pour l'entreprise
- Nos réalisations
Construisons votre copilote de connaissance
Vous voulez qu'une IA connaisse réellement votre entreprise, sans compromis sur la confidentialité ? Parlons de vos sources, de vos cas d'usage et de votre infrastructure.
- Contact Apeiron : contact@apeiron-tech.com
- Parlez-nous de votre projet